缓存设计实战:从命中、失效到多级缓存
缓存设计实战:从命中、失效到多级缓存
缓存能把重复读取挡在数据库之外,也可能让用户读到旧数据。设计缓存时,先问四件事:缓存什么、用什么 key、何时失效、写入后如何保持可接受的一致性。这篇文章以《缓存体系分析》中的 Java 项目为例,拆解它的本地缓存,并用一个可操作的模型演示
缓存能把重复读取挡在数据库之外,也可能让用户读到旧数据。设计缓存时,先问四件事:缓存什么、用什么 key、何时失效、写入后如何保持可接受的一致性。这篇文章以《缓存体系分析》中的 Java 项目为例,拆解它的本地缓存,并用一个可操作的模型演示多级缓存的读写过程。
本文中的容量和过期时间是原文项目的配置,不是 Guava、Caffeine 或 Spring Cache 的默认值。模拟器只展示关键状态转换,不等同于某个库的完整并发实现。
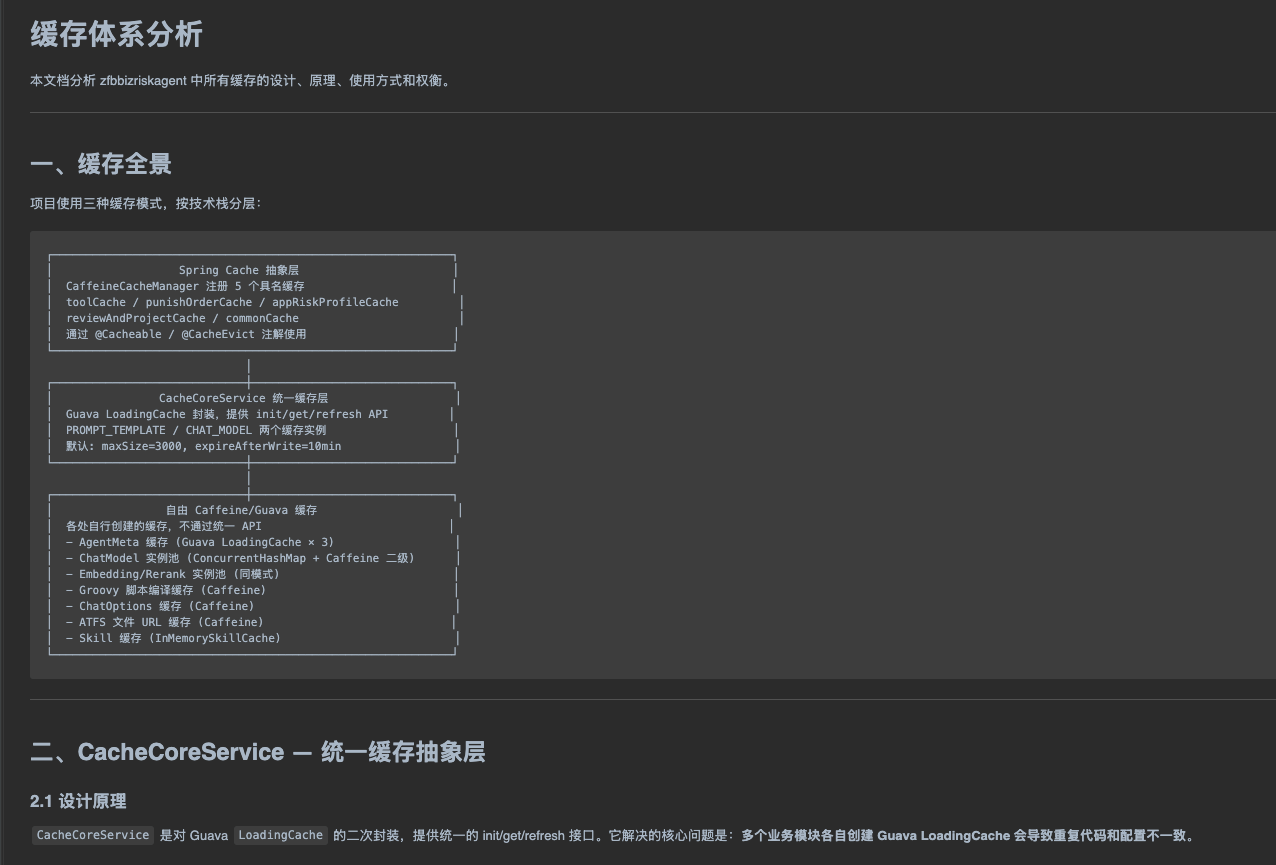
一、先看全貌:缓存不止一层
这套系统的缓存可以按用途分成三组:统一的业务数据缓存、启动或运行时的实例缓存,以及 Spring Cache 注解管理的接口结果缓存。它们都在应用进程的 JVM 内,并没有形成一个跨节点共享的 Redis 缓存。
| 层次 | 典型实现 | 缓存内容 | 设计目的 |
|---|---|---|---|
| 统一缓存层 | Guava LoadingCache + CacheCoreService | 提示词模板、模型配置 | 收敛注册、加载和主动刷新入口 |
| 业务内存层 | Guava、Caffeine、ConcurrentHashMap | Agent 元数据、模型实例、脚本编译结果 | 按访问方式选择不同生命周期 |
| 注解层 | Spring Cache + Caffeine | 工具、工单、风险画像等查询结果 | 让查询方法复用统一的缓存声明 |
**先按对象的生命周期设计,再选缓存库。**模板和配置允许短时间陈旧,适合带 TTL 的缓存;模型实例创建成本高,但无过期的实例池需要额外的生命周期管理;临时 URL 过期后可能失效,缓存 TTL 不应长于其有效期。
二、一次读取究竟发生了什么
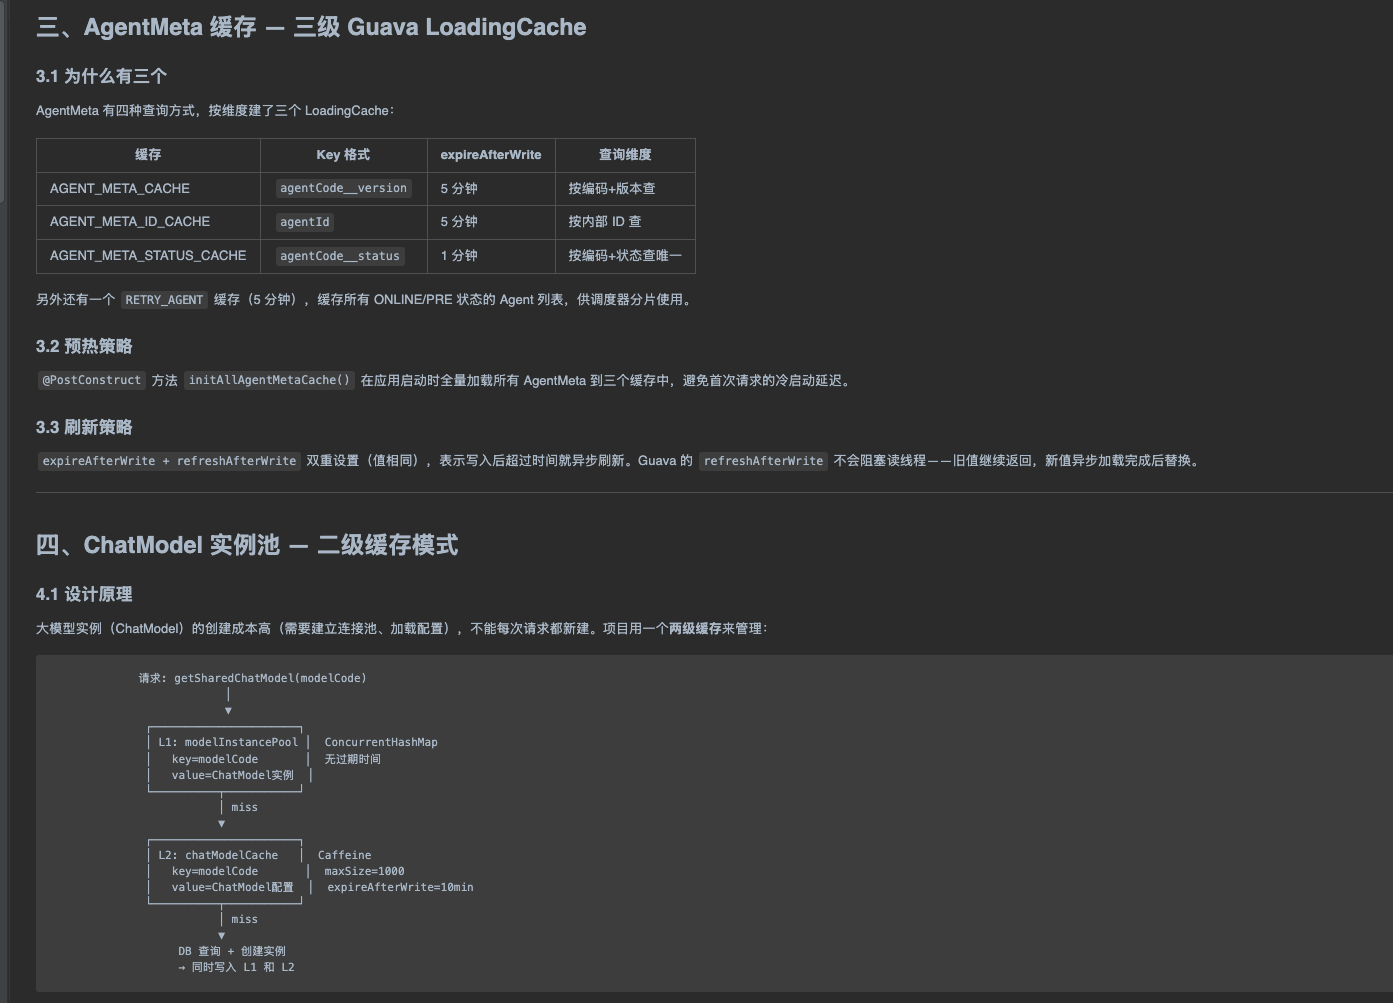
最常见的是旁路缓存(cache-aside):先查缓存;未命中时查数据源,再把结果写入缓存。二级缓存会多一次判断:先查 L1 实例池,再查 L2 配置缓存,最后访问数据库。原文的 ChatModel 实例池就是这种思路:L1 按 modelCode 保存已创建的实例,L2 保存模型配置,L2 的示例容量为 1000、写入后 10 分钟过期。
下面的模型把 L1 简化为实例持有的“配置版本”,方便看清旧数据如何传播。实际模型实例还可能持有连接、线程等资源,更新时应评估其关闭与替换过程。
试着让缓存读到新版本
建议顺序:读取两次 → 更新数据库 → 读取 → 只清除 L1 → 读取 → 清除两级缓存 → 读取。
上面的旧读不是模拟器的偶然现象:只清除 L1,L2 仍可能把旧配置重新装回 L1。更新数据库后,应按业务要求失效所有相关缓存,或者让缓存 key 带版本。若只依赖 TTL,系统接受的是一个明确的陈旧窗口。
三、key、过期与刷新要一起设计
原文里的 AgentMeta 同一对象有三种查询维度,因此拆成三个 LoadingCache:agentCode_version(5 分钟)、agentId(5 分钟)和 agentCode_status(1 分钟)。这不是复制三份代码,而是让每种查询都能用稳定、唯一且可解释的 key命中。更新一条 Agent 元数据时,也必须找出这三个入口分别失效,否则其中一个视图仍可能是旧的。
原文还在启动阶段预热 AgentMeta,减少首个请求的加载延迟。预热会增加启动耗时和瞬时内存占用;若数据量增长,宜限定批次或预热范围。
过期策略回答的问题不同:
| 策略 | 计时起点 | 适合对象 | 主要代价 |
|---|---|---|---|
expireAfterWrite | 写入或替换后 | 配置、模板、状态快照 | 热 key 到期仍要重新加载 |
expireAfterAccess | 最近一次访问后 | 编译结果、近期使用的选项 | 冷数据能淘汰,热点可能长期留存 |
| 主动失效 / 刷新 | 业务变更发生时 | 配置发布、模板修改 | 必须找齐所有相关 key 和节点 |
原文的统一缓存层把 PROMPT_TEMPLATE 和 CHAT_MODEL 注册到 CacheCoreService,默认示例为最多 3000 项、写入后 10 分钟过期。模板通过 DRM 变更回调主动调用 refreshCache,尽量缩短等待 TTL 的时间。Guava 的 refreshAfterWrite 与主动 refresh(key) 的具体阻塞和旧值返回行为,取决于 CacheLoader.reload 如何实现,不能仅凭配置名断言“刷新一定异步”。
**空值也要有策略。**原文在数据库找不到模板时放入占位对象,避免同一个不存在的 key 每次穿透到数据库。代价是新建数据后必须清除该空值;还要区分“确实不存在”和“数据库暂时故障”,不能把故障结果长期缓存为不存在。
四、不同对象需要不同的缓存
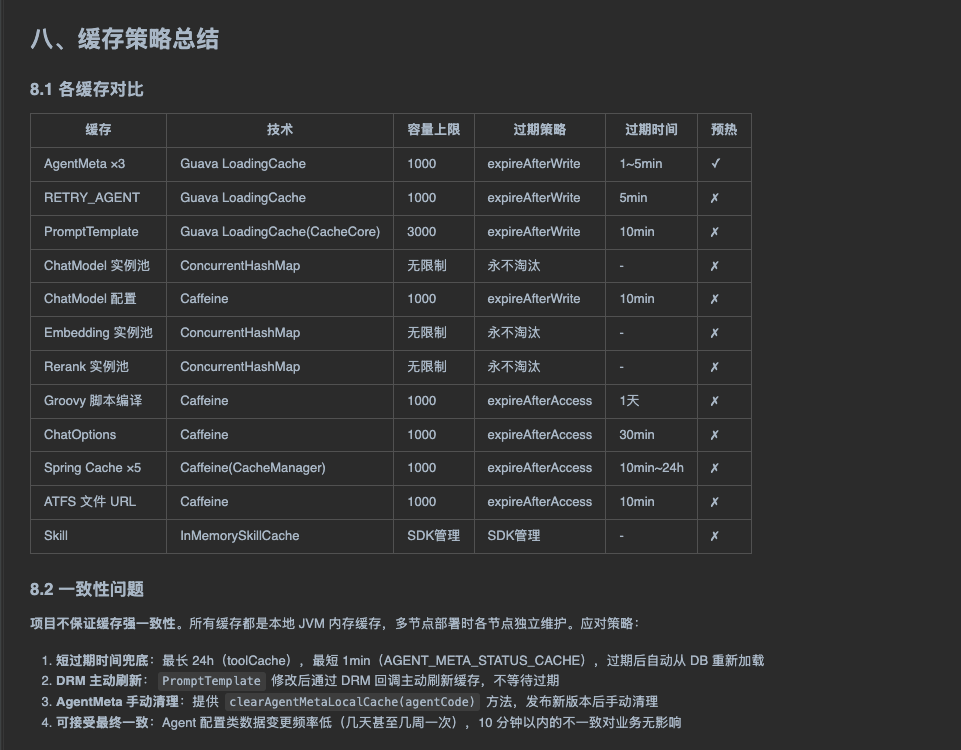
**模型实例池。**ChatModel、Embedding 和 Rerank 实例创建成本较高,因此原文用 ConcurrentHashMap 复用。它们没有 TTL,也没有统一容量上限。只要模型种类有界,这样做可能合理;但配置变更、实例关闭、并发重复创建和未来 key 增长都应有明确处理。get 后再 put 并非原子创建,多线程同时 miss 时可能各建一个实例。
**Groovy 编译缓存。**脚本文本先算 MD5,再缓存编译后的 Class,示例为最多 1000 项、访问后 1 天过期。内容哈希让相同脚本只编译一次;如果脚本来源不可信或正确性要求严格,应使用更强的哈希,并把运行环境或编译选项纳入 key。脚本变更后也可主动失效,不必等一天。
Spring Cache。@Cacheable 用在查询方法上,@CacheEvict 用于业务写入后的清理。原文配置了 toolCache、punishOrderCache、appRiskProfileCache、reviewAndProjectCache、commonCache 五组 Caffeine 缓存,示例 TTL 从 10 分钟到 24 小时。注解减少样板代码,但要检查方法是否经过 Spring 代理、key 是否包含所有查询条件,以及写操作是否清除了正确的缓存项。
**其他短期对象。**ChatOptions 示例按 Agent ID 缓存 30 分钟;ATFS 文件 URL 缓存 10 分钟;Skill 由 SDK 的内存缓存管理。尤其是带有效期的外部 URL,本地缓存的时间必须与上游链接的实际有效期协调。
五、缓存正确性比命中率重要
这套系统的缓存都是本地 JVM 内存。节点 A 收到配置变更回调并失效缓存,节点 B 不会因此自动失效。因此它提供的是有边界的最终一致性,不是强一致。文档中的 1 至 24 小时 TTL、主动刷新、版本查询和预热,是不同缓存各自的折中;不能用一个统一的“10 分钟内一致”概括全部对象。
上线前至少回答这些问题:
- **谁写数据?**写入数据库成功后,哪些 key、哪些缓存层、哪些节点需要失效?
- **最多能旧多久?**分别量化 TTL、变更通知延迟,以及通知失败后的兜底窗口。
- **会占多少内存?**给大对象和实例池估算容量,观察命中率、淘汰量、加载时长和 JVM 堆使用。
- **未命中会怎样?**防止热点 key 同时重建、空 key 重复穿透,以及数据库故障被误缓存。
- **如何回滚?**配置发布失败时,缓存如何回到与数据库一致的版本?
缓存的边界应写进业务契约:什么数据可以短暂过期、最长能旧多久、变化后由谁通知。没有这个契约,TTL 只是一个猜测。